「ChatGPTに聞いたら、うちではなく競合が紹介されていた」——2026年、こうした声が急増しています。ユーザーはGoogleの検索結果だけでなく、ChatGPT・Gemini・Perplexity・GoogleのAI Overviews(AIによる概要)に直接質問し、その回答を見て意思決定するようになりました。AIが生成する回答のなかで自社が「引用・言及される」かどうかが、新しい集客の分かれ目です。
本記事では、この生成AIに引用されるための最適化=LLMO対策について、定義・仕組み・具体的な7施策・効果測定・90日ロードマップまでを、2026年時点の最新情報にもとづいてこれ一本で完結するレベルで解説します。さらに、LLMO対策で最大のボトルネックになる「コンテンツの量産」を自動化する方法も最後にご紹介します。
結論:LLMO対策とは「AIに引用される構造化コンテンツを出し続けること」
先に結論です。LLMO(Large Language Model Optimization=大規模言語モデル最適化)とは、ChatGPT・Gemini・Claude・Perplexityなどの生成AIや、Google検索内のAI Overviewsに対して、自社のブランドやコンテンツを正しく理解させ、AIが生成する回答のなかで参照・言及・引用されるようにするための施策です。やることを一言でいえば「AIが抜き出しやすい、信頼できる情報を、網羅的に出し続ける」——これに尽きます。以降で、その中身を分解していきます。
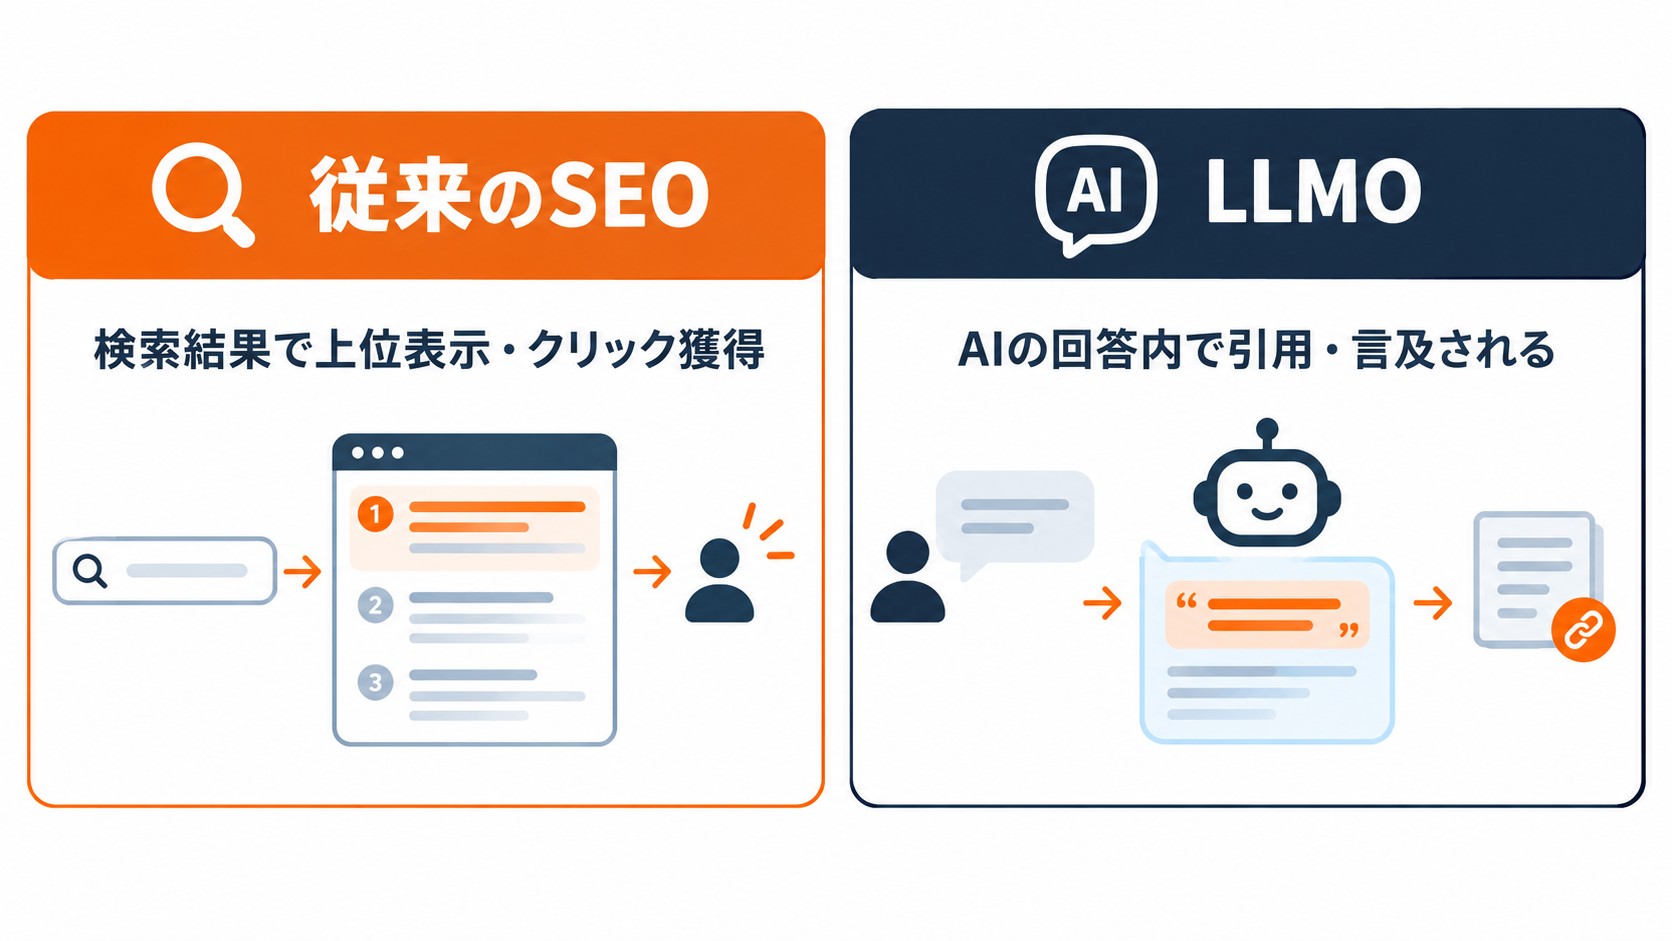
SEOとの違いは「ゴール」にある
AIO・GEO・AEOとの関係を整理する
LLMOと似た言葉に、AIO・GEO・AEOがあります。呼び方は各社で微妙に異なりますが、いずれも「生成AI・AI検索に引用されるための最適化」という点で本質は同じです。下図のように、SEOという土台の上に、AI向けの最適化概念が重なっていると捉えてください。
- AIO(AI Optimization):AI検索全般に向けた最適化。ほぼLLMOと同義で使われる
- GEO(Generative Engine Optimization):生成エンジン(AI)に最適化するという英語圏発の呼称
- AEO(Answer Engine Optimization):AIを「回答エンジン」と捉えた最適化。Q&A設計に力点
本記事では最も一般的なLLMOに統一して解説します。重要なのは名前ではなく、LLMOはSEOの代替ではなく拡張だという点です。生成AIも回答の根拠として最終的にはWeb上のインデックス情報を参照します。クロール・インデックス、本文のテキスト、内部リンク、構造化データ、著者情報といったSEOの土台は、LLMOでもそのまま必要です。
なぜ今、LLMO対策が必要なのか
ユーザーの情報収集行動が、検索エンジンから生成AIへと確実にシフトしているからです。「まずAIに聞いてから、必要なら検索する」という順序が一般化し、購買や問い合わせの検討プロセスにAIが入り込んでいます。実際、問い合わせ客に認知経路をヒアリングすると「生成AIで調べて知った」と答える比率が、2025年後半から無視できない水準(実務では約半数に達する例も)まで上がってきたと報告されています。
検索 → 複数サイト比較 → 判断
AIに質問 → AIの回答で判断 → 必要なら検索
AIの回答に載らなければ、そもそも検討の土俵にすら上がれません。「AIに選ばれる情報源になる」こと自体が、これからの集客の前提条件になりつつあります。
生成AIが引用元を選ぶ仕組み
対策を理解するには、AIがどう回答を組み立てるのかを押さえるのが近道です。ポイントは3つあります。
仕組み①:RAG(検索拡張生成)とグラウンディング
多くのAI検索はRAG(Retrieval-Augmented Generation=検索拡張生成)という仕組みを使います。AIが回答を作る前にWeb検索で関連情報を取得し、それを根拠(グラウンディング)として回答に織り込む方式です。
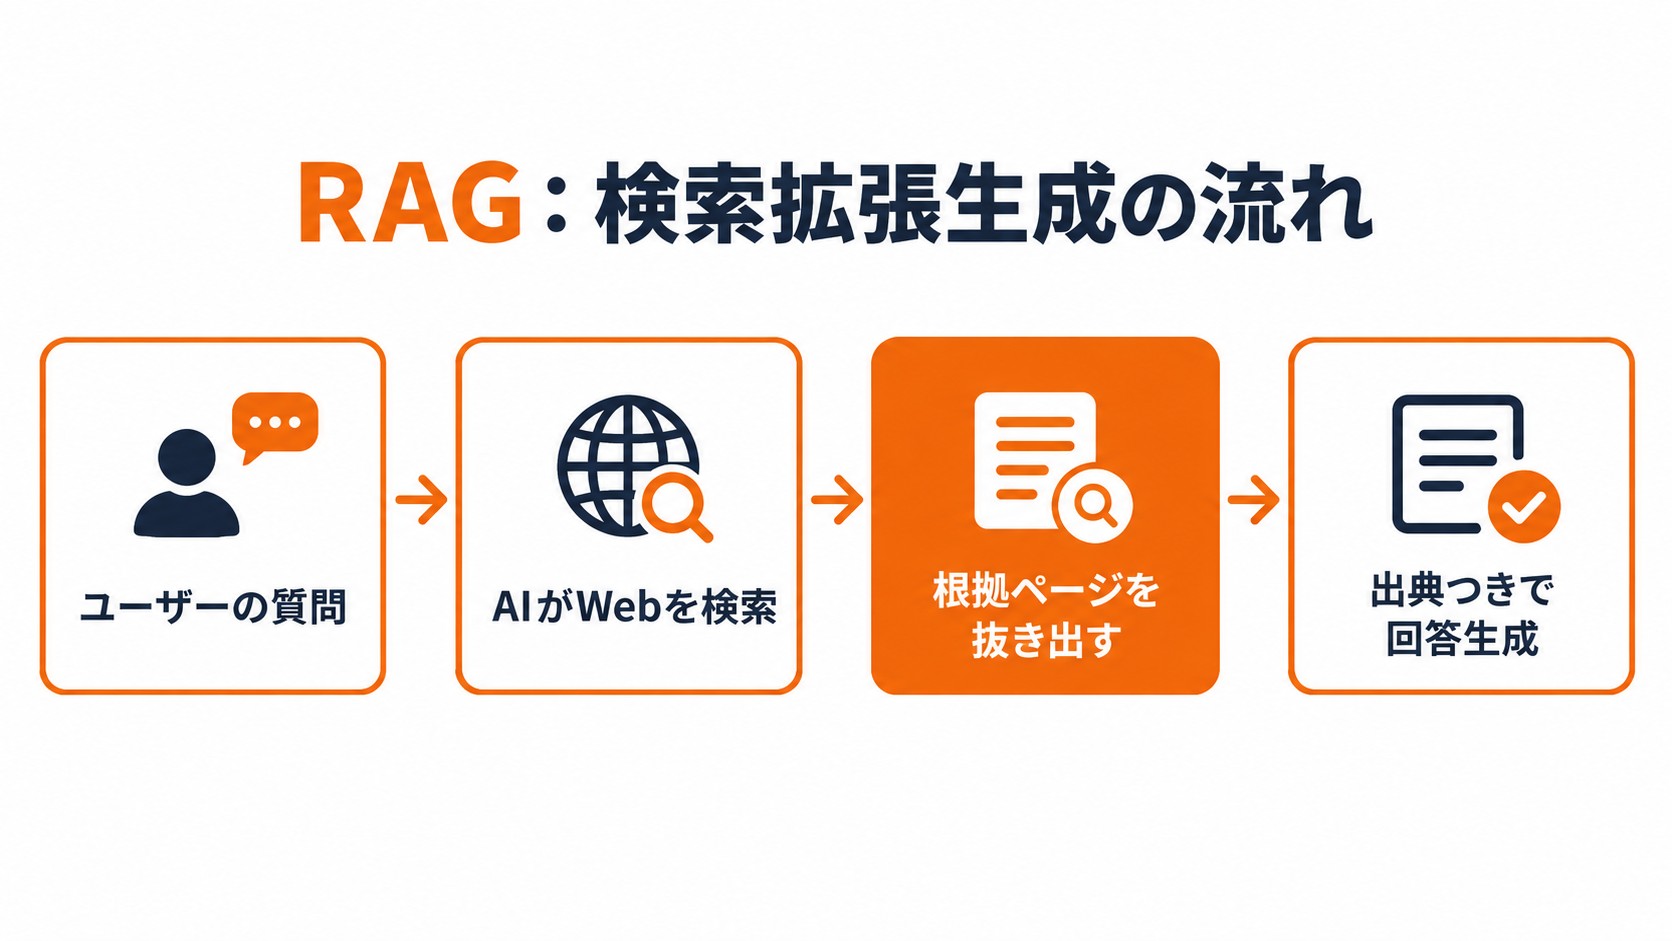
つまり、検索でヒットしやすく、根拠として抜き出しやすいページが引用されやすくなります。これがLLMOとSEOが地続きである理由です。
仕組み②:クエリファンアウト(質問の分解)
AI Overviewsなどは、ユーザーの1つの質問を複数のサブ質問に分解して並行探索します。これをクエリファンアウトと呼びます。
SEOとの違いは?
構造化データの実装
効果測定の方法
llms.txtは必要?
そのため、主要テーマだけでなく周辺の疑問まで網羅的に答えたコンテンツが選ばれやすくなります。本記事があえて定義から効果測定・ロードマップまで一気通貫で扱っているのも、この特性に合わせているためです。
仕組み③:Lost in the Middle(中央の取りこぼし)
AIは長文を処理する際、冒頭と末尾の情報は拾いやすい一方、真ん中の情報は取りこぼしやすいという特性があります。対策はシンプルで、結論・定義を記事の冒頭に置き、末尾のまとめ付近にも別表現で結論を再掲すること。本記事も「結論」を冒頭に、まとめを末尾に配置しています。
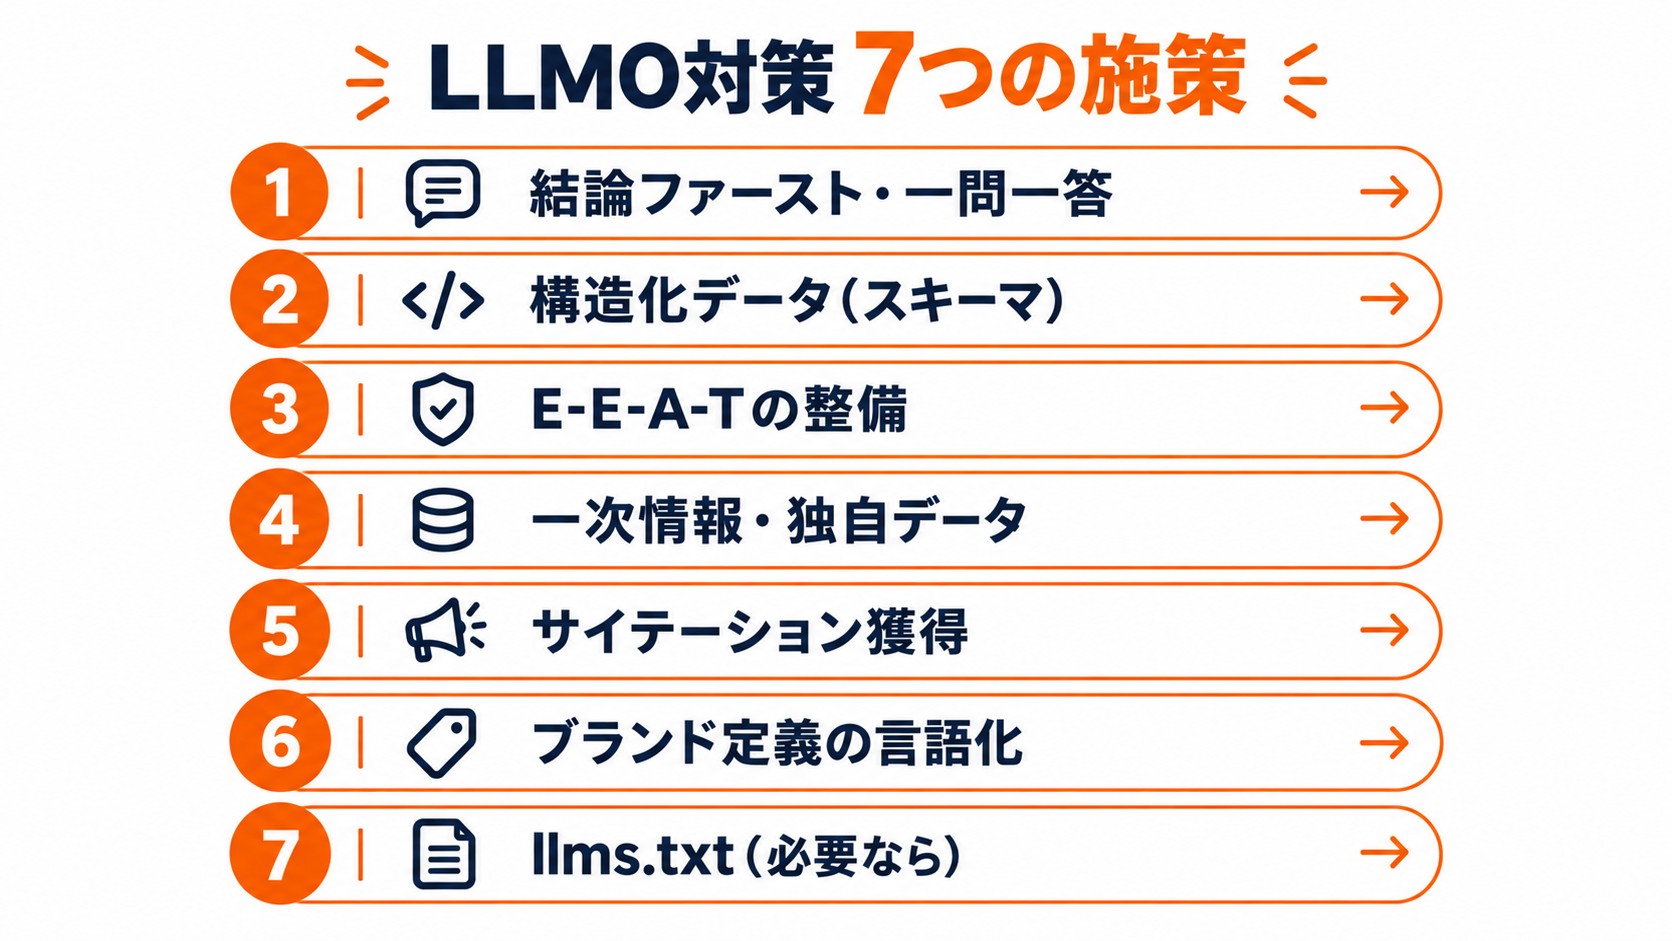
LLMO対策のやり方【7つの施策】
ここからが本題です。優先度の高い順に、具体的なやり方を7つ、それぞれ「やること」と「チェックリスト」つきで解説します。
施策①:結論ファースト・一問一答の構成にする
AIは「抜き出して、そのまま回答に使える」記述を好みます。見出しごとに論点を1つに絞り、問いに対する結論を先に、簡潔に書きましょう。だらだらした前置きや、結論が最後まで出てこない文章は引用されません。
チェック:☐ 各見出し直後に結論がある ☐ FAQ/要点ブロックがある ☐ 一文抜き出しで意味が通る
施策②:構造化データ(スキーマ)を実装する
構造化データ(Schema.org / JSON-LD)は、ページ内容を機械が正確に理解するための「翻訳」です。誰が・いつ・何について書いたのかをAIに明示でき、E-E-A-Tの技術的裏付けにもなります。1ページに複数実装すると引用されやすさはさらに高まります。優先度は次のとおりです。
| スキーマ | 役割 |
|---|---|
| Organization / WebSite | 企業・ブランド・サイト主体を正確に識別させる |
| Article / BlogPosting | 記事の著者・公開日・見出しを明示 |
| Author / Person | 執筆者の専門性を補足しE-E-A-Tを裏づけ |
| FAQPage | Q&A形式を整理し抜き出されやすくする |
| Product / Service | サービス内容を機械に理解させる |
JSON-LDで記述し、Googleの「リッチリザルトテスト」で検証するのが基本の流れです。チェック:☐ 4大スキーマ(Article/FAQPage/Organization/BreadcrumbList)を実装 ☐ リッチリザルトテストでエラーなし
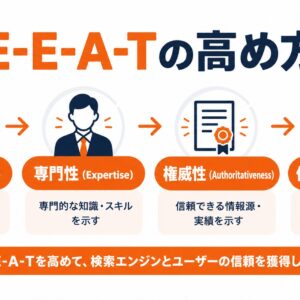
施策③:E-E-A-T(経験・専門性・権威性・信頼性)を整える
AIは「誰が言っているか」を重視します。著者欄に名前を書くだけでなく、その人物がどの分野の専門家なのかまで明記しましょう。
経験
実体験・一次情報
専門性
著者の分野明記
権威性
外部からの言及
信頼性
出典・表記統一
監修者をつける、根拠となる一次情報へのリンクをたどれる状態にする、社名・サービス名の表記を統一する——こうした積み重ねが「信頼できる情報源」という判断につながります。
施策④:一次情報・独自データを盛り込む
AIは、憶測や個人的な感想よりも、権威ある人物の発言・エビデンス・独自の調査データを優先して拾う傾向があります。自社で取得したデータ、実測値、事例の数字は、他サイトが持っていない「引用する価値のある情報」です。独自データは、そのままLLMOにおける最強の差別化要因になります。アンケート結果、導入前後の数値、現場の失敗談など、自社にしか出せない一次情報を1記事に最低1つ入れることを目安にしましょう。
施策⑤:サイテーション(外部での言及)を獲得する
対話型AIは、事前学習データやWeb全体での評判をもとに「このカテゴリならこのブランド」という認識を形成します。自社サイトの外でどれだけ言及されているかが効いてくるということです。サイト掲載数とAI言及数には強い正の相関があると報告されています。
施策⑥:エンティティ(ブランド定義)を言語化する
AIに正しく認識されるには、まず自社が「何者か」を社内で明確にする必要があります。次の3つの問いに答えられるようにしておきましょう。
この定義が曖昧だと、コンテンツも外部発信もぶれ、AIも自社を正しく分類できません。まず社内でこの3問に一文ずつ答え、全コンテンツの軸に据えましょう。
施策⑦:llms.txt は「必要なら」設置する
AIクローラー向けにサイト情報を伝えるllms.txtという仕組みがありますが、必須ではありません。各AIで自社がすでに正しく認識されているなら設置は不要です。認識が弱い・誤っている場合の補助手段として検討する程度で十分。優先すべきは、あくまで①〜⑥のコンテンツと評判づくりです。
LLMO対策の効果測定:AI言及率(Share of Voice)
「AIに引用されているか」は、放置すると分かりません。中心指標はAI言及率(Share of Voice)です。次の手順で月次計測しましょう。
あわせて、指名検索の変化(Search Console)や、問い合わせ時の「AI経由で知った」比率もモニタリングします。AI言及率は結果指標(遅行指標)なので、それを動かす行動KPI——サイテーション獲得数、コンテンツの新規公開・改修数——も同時に測りましょう。
90日実行ロードマップ
何から着手すべきか。3か月で成果の出やすい順に整理しました。
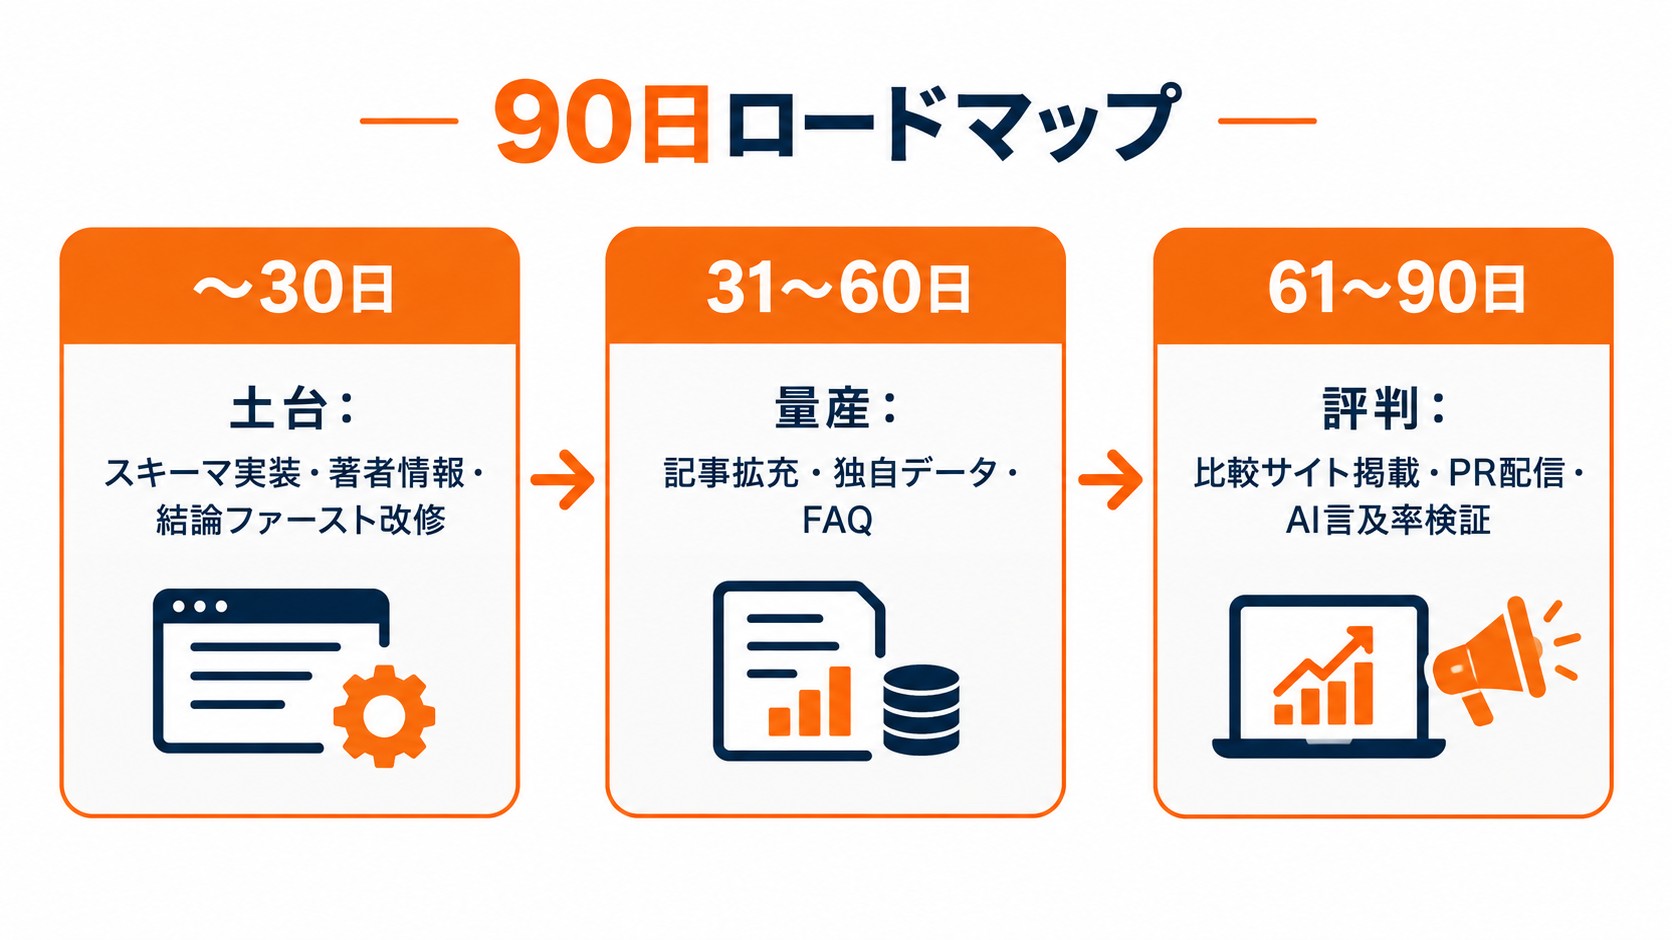
ここで気づく方も多いはずです。31日以降の「量産」フェーズこそ、LLMO対策で挫折しやすい最大の壁だということに。
LLMO対策の最大の壁は「コンテンツの量産」
ここまで読むと分かるとおり、LLMO対策は「質の高い構造化コンテンツを、網羅的に、出し続ける」ことに集約されます。結論ファーストの構成、スキーマ実装、E-E-A-Tの整備、周辺サブクエリまでの網羅、図解——これを1本ずつ人力でやると、現実的には手が回りません。LLMO対策で成果が出ない最大の理由は、施策を知らないことではなく「量産が続かないこと」です。
posti:LLMO最適化コンテンツを自動生成し、WordPressへ
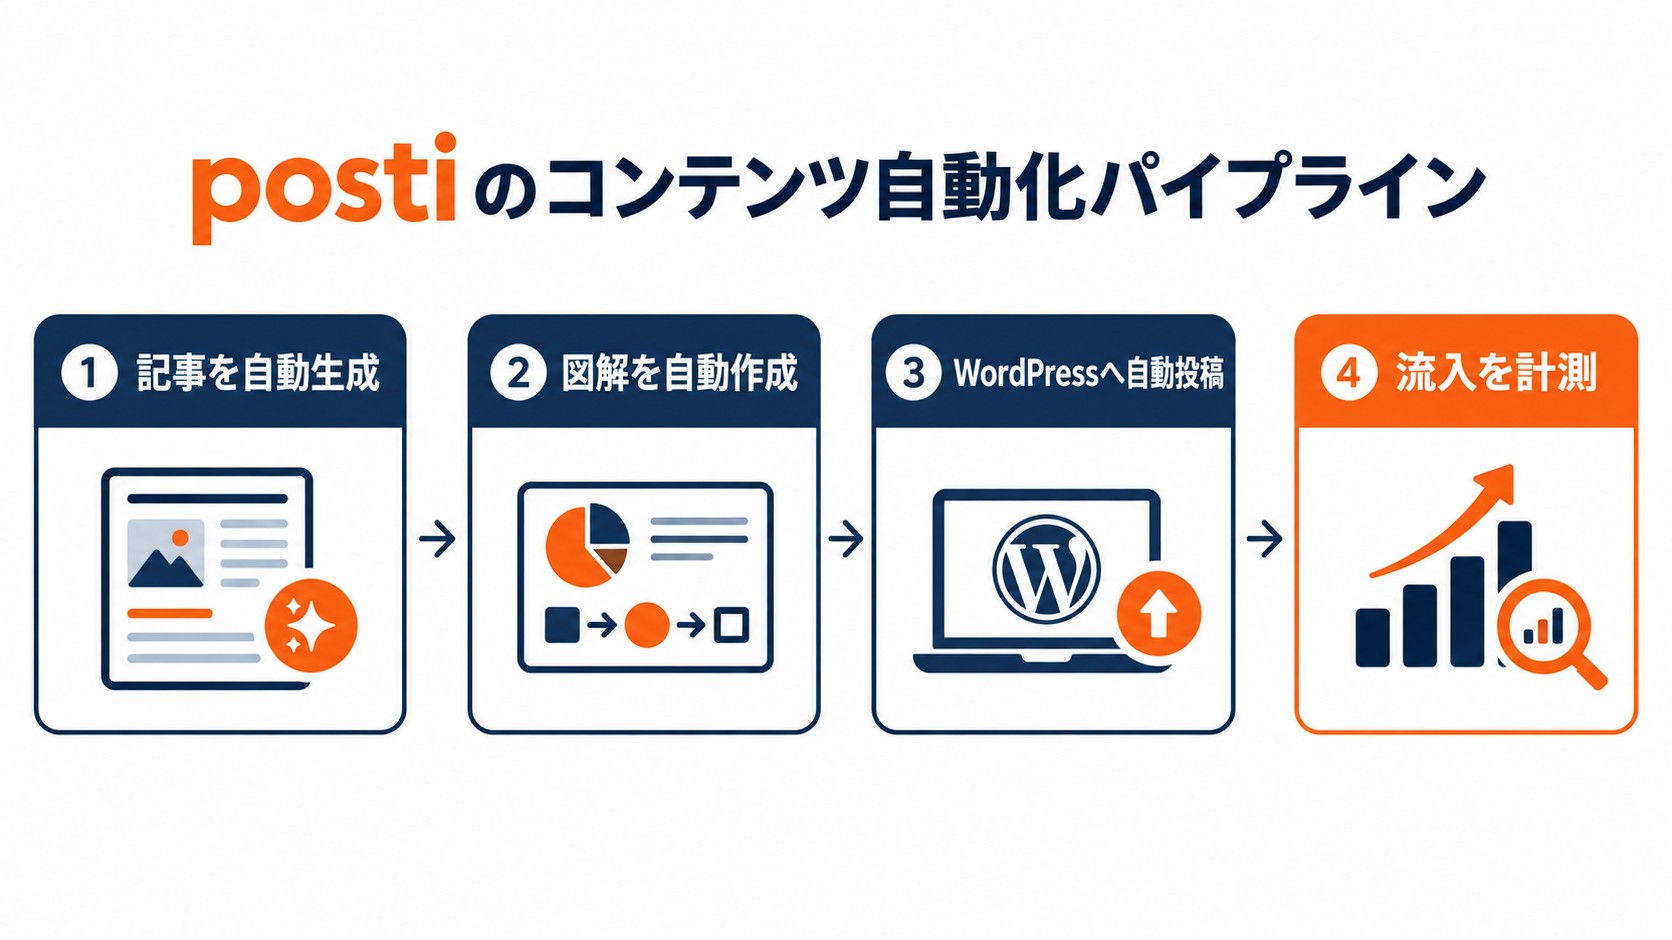
この量産の壁を解決するのが、当社が提供するマーケティング自動化ツール posti です。postiは、本記事で解説したLLMOの要件を満たすコンテンツを自動生成し、図解で装飾し、WordPressへ直接投稿し、流入までを計測する——ここまでを一気通貫で自動化します。
実績:posti産コンテンツだけで流入が積み上がっている
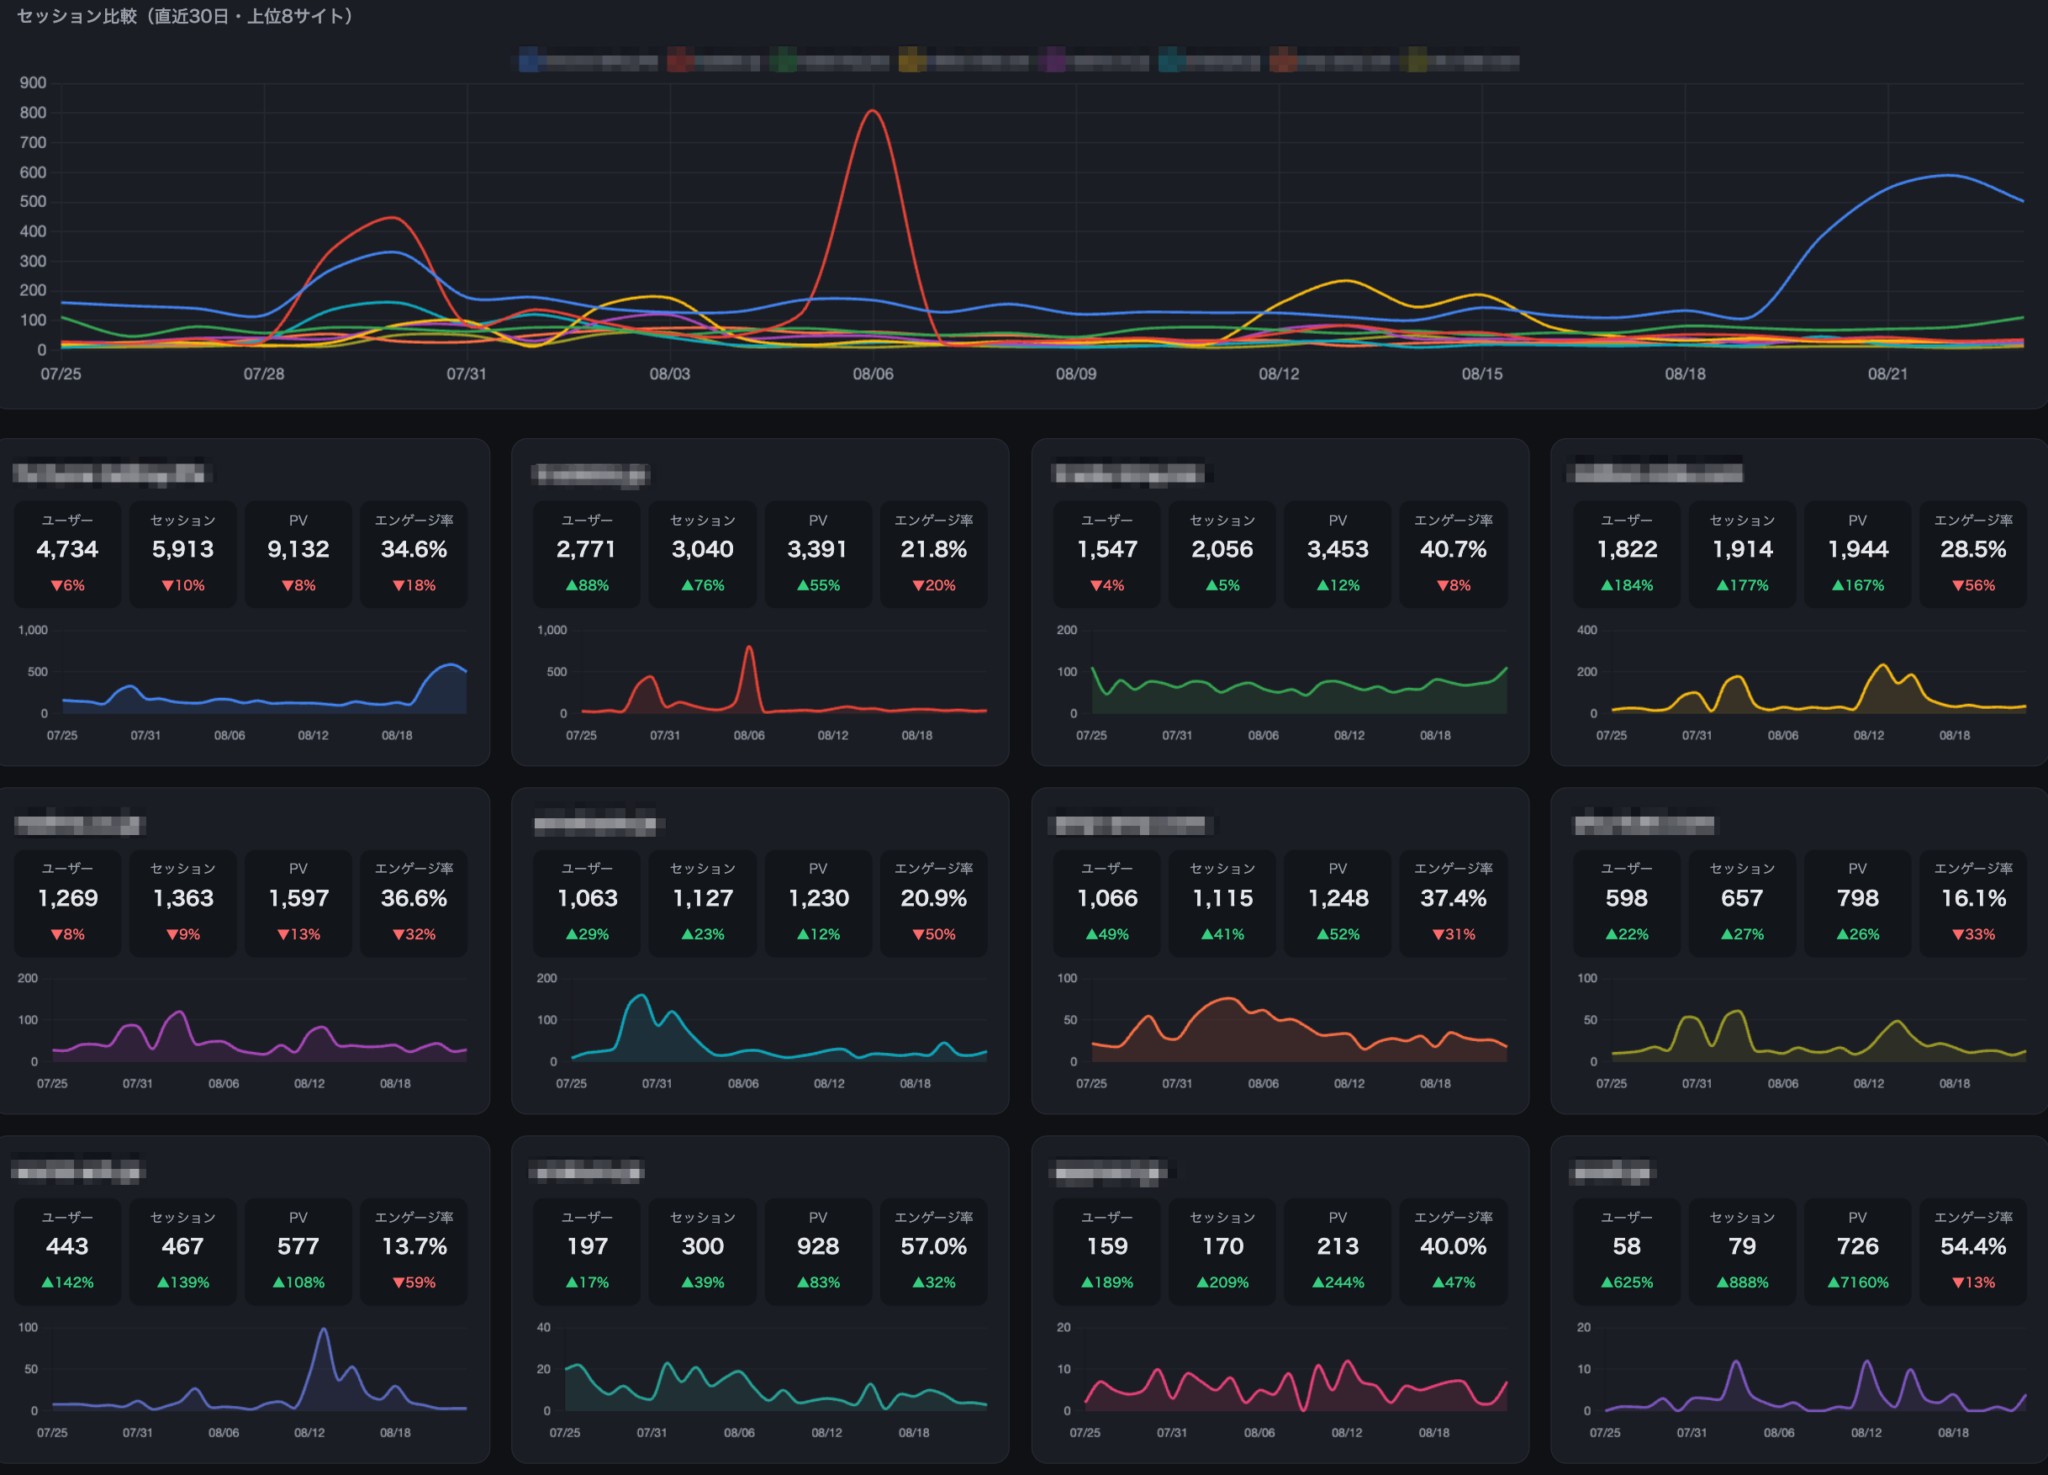
下のダッシュボードは、postiが自動生成・投稿したコンテンツで運用しているサイト群の直近30日のセッション推移(サイト名は非表示)です。広告に頼らず、自動生成したコンテンツだけで検索流入が右肩上がりに積み上がっていく様子が確認できます。前月比でセッション+177%、PV+167%や、立ち上げ期のサイトで+888%といった伸びも出ています。
LLMO対策で「何を書けばいいか」は本記事のとおりです。あとはそれを継続的に量産できるかどうか——そこをpostiが引き受けます。
よくある質問(FAQ)
Q. LLMO対策をすればSEO対策は不要になりますか。
A. いいえ。生成AIも最終的にはWeb上のインデックス情報を参照するため、クロール・インデックス・内部リンク・構造化データといったSEOの土台はLLMOでも必要です。LLMOはSEOの代替ではなく拡張と考えてください。
Q. LLMO対策はどのくらいで効果が出ますか。
A. 土台整備は即時、コンテンツ量産と評判形成は3か月前後で変化が見え始めるのが目安です。まず90日ロードマップの「土台」から着手し、AI言及率をベースライン計測しておくと進捗が可視化できます。
Q. llms.txt は必ず設置すべきですか。
A. 必須ではありません。各AIで自社が正しく認識されていれば不要です。認識が弱い場合の補助手段として検討する程度で、優先すべきはコンテンツと外部での評判づくりです。
Q. LLMO対策の効果はどう測ればよいですか。
A. 主要な質問を10〜20個用意し、ChatGPT・Gemini・Claude・Perplexityに投げて回答に自社名が含まれる割合(AI言及率)を月次で計測します。あわせて指名検索の変化や、問い合わせ時の「AI経由で知った」比率も追うと実態がつかめます。
Q. 中小企業でもLLMO対策はできますか。
A. できます。むしろ独自データや現場の一次情報を持つ中小企業は、AIに引用されやすい素材を持っています。課題は量産の継続で、そこは posti のような自動化ツールで補えます。
Q. posti は何を自動化してくれますか。
A. LLMOの要件を満たす構造化コンテンツの生成、図解の作成、WordPressへの投稿、流入の計測までを一気通貫で自動化します。「何を書くか」の設計から「出し続ける」運用までを引き受けます。
まとめ
LLMO対策の本質は、AIに引用される構造化コンテンツを、網羅的に出し続けることです。やることは、①結論ファースト ②構造化データ ③E-E-A-T ④一次情報 ⑤サイテーション ⑥ブランド定義 ⑦(必要なら)llms.txt の7施策と、AI言及率での効果測定。施策の中身は本記事のとおりですが、成否を分けるのは量産の継続力です。自動でLLMO対策したコンテンツで集客したい方は、posti をご検討ください。